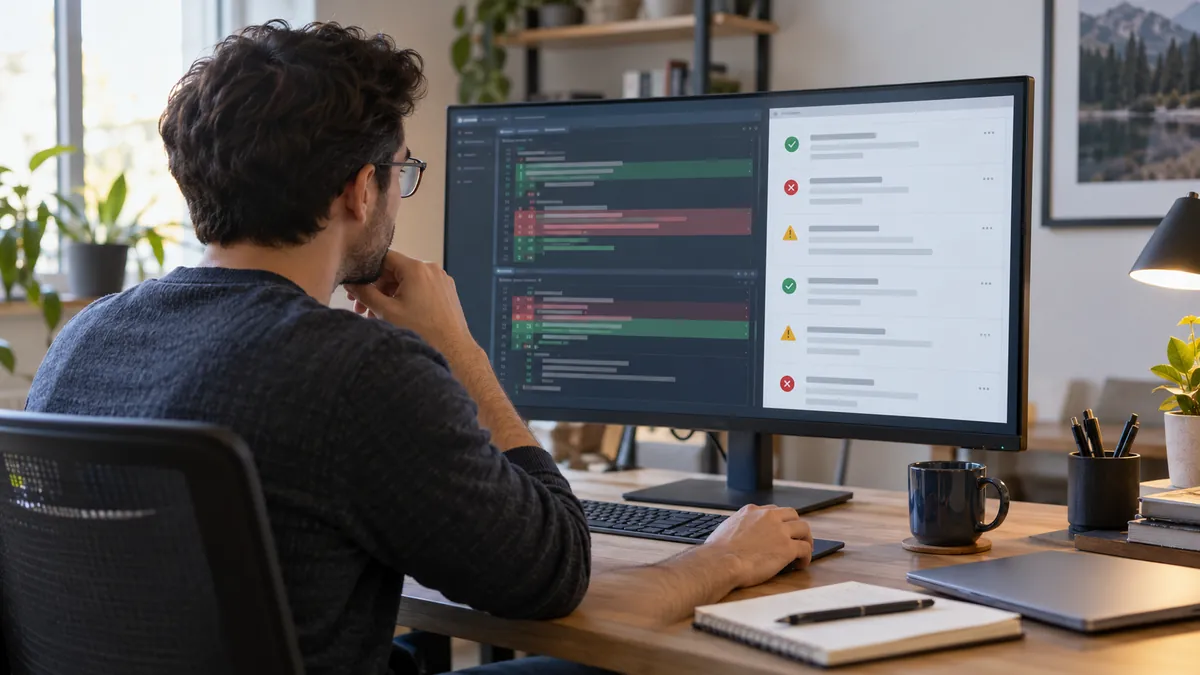
ReviewBench pone una regla común a una pregunta que suele responderse con demos: ¿qué revisor de código con IA detecta problemas útiles sin llenar una pull request de ruido? GitHub presentó este benchmark abierto el 5 de octubre de 2026 con 219 cambios reales de proyectos públicos, etiquetas por gravedad y métricas de precisión y cobertura. No se limita a contar comentarios. Intenta distinguir entre un fallo relevante, una observación menor y una falsa alarma. En este análisis explicamos qué mide y qué debería comprobar un equipo antes de usar sus resultados para elegir una herramienta.
Transparencia editorial: este artículo analiza la documentación pública de GitHub y ReviewBench. No hemos ejecutado el benchmark ni probado los revisores de su clasificación. No contiene enlaces de afiliado.
Qué es ReviewBench y por qué llega en un momento oportuno
GitHub describe ReviewBench como un banco de pruebas para agentes de revisión de código. Su punto de partida es ambicioso: la empresa analizó la distribución de 103,9 millones de pull requests para aproximar lenguajes, tamaño de repositorio y forma de los cambios. A partir de ahí construyó un corpus de 219 pull requests, 187 repositorios públicos y 19 lenguajes.
El conjunto da más peso a cambios medianos y grandes para evitar que dominen las modificaciones diminutas de un solo archivo. Es una decisión razonable para evaluar revisiones sustanciosas, pero significa que la muestra no es una fotografía neutral de todo GitHub.
El anuncio y la metodología están en la presentación oficial de ReviewBench publicada por GitHub. El conjunto completo, el evaluador y el proceso para presentar un agente se ofrecen desde la web pública del benchmark, todavía identificada como versión preliminar de investigación.
Precisión y cobertura: no existe un único “mejor” revisor
La idea más útil de ReviewBench no es un ganador, sino la separación entre precisión y recall o cobertura. La precisión pregunta cuántos comentarios del revisor eran válidos. La cobertura pregunta cuántos de los problemas conocidos llegó a detectar. Un sistema puede encontrar más fallos y, al mismo tiempo, molestar con más avisos incorrectos. Otro puede ser muy prudente y dejar pasar problemas importantes.
El benchmark calcula métricas “grounded”, limitadas al conjunto de hallazgos ya validado, y métricas “augmented”, que permiten reconocer un problema nuevo aunque no figurase en ese conjunto. También clasifica los hallazgos por gravedad y categoría, como corrección, seguridad, fiabilidad, mantenibilidad o pruebas. El parámetro F beta permite dar más peso a la precisión o a la cobertura según el uso.
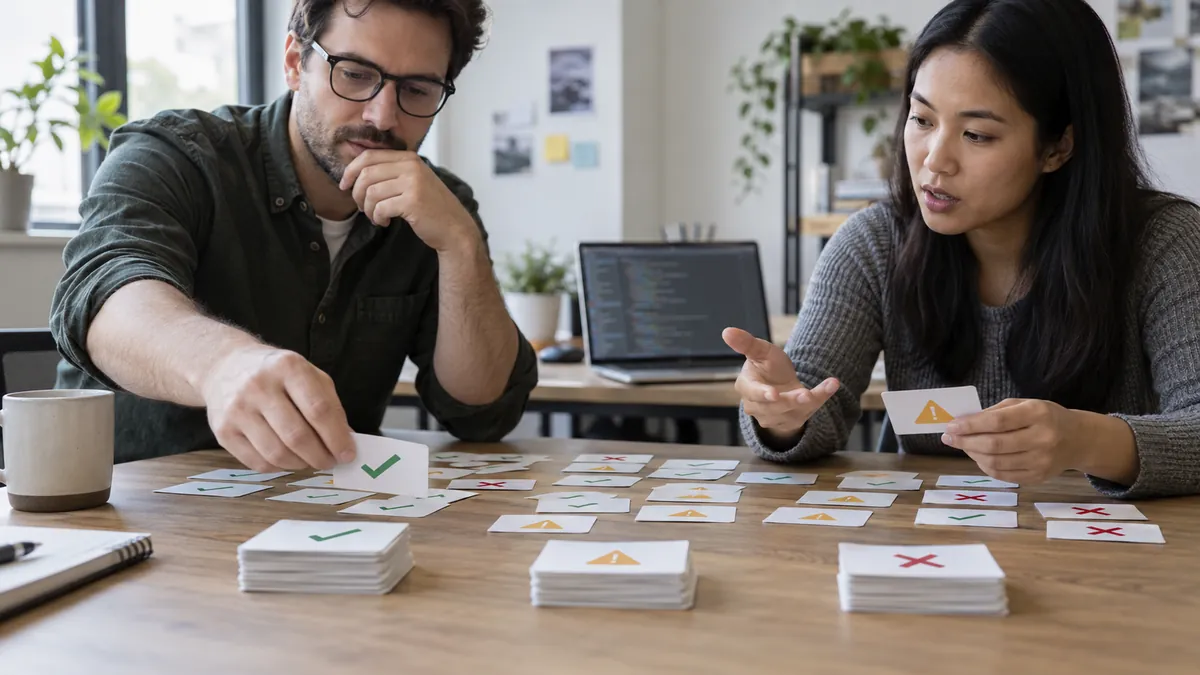
Para un comentario informativo puede ser aceptable ampliar la cobertura y revisar algún falso positivo. Para bloquear una fusión automática, una precisión baja sería carísima: obliga a justificar excepciones y enseña al equipo a ignorar alertas. Por eso una nota global no basta.
Cómo construye GitHub el conjunto de respuestas correctas
El “golden set”, la referencia contra la que se puntúa, combina varias fuentes: comentarios de revisores humanos, correcciones posteriores de los autores, herramientas de análisis determinista y varios modelos avanzados. Después se agrupan los hallazgos equivalentes para evitar contar dos veces el mismo problema.
La validación final usa una rúbrica común y Claude Sonnet 5 como juez automático. GitHub afirma que ingenieros sénior externos a la construcción del conjunto volvieron a etiquetar los hallazgos y coincidieron con ReviewBench en el 96,6 % de los casos. Es una señal favorable, aunque no elimina el posible sesgo del juez.
Esta capa de control importa. Como contamos al analizar los límites de ejecución para agentes de IA, delegar una tarea no equivale a delegar la responsabilidad. En revisión de código ocurre lo mismo: un comentario bien escrito puede sonar convincente y seguir siendo técnicamente incorrecto.
Qué demuestra la comparación con producción y qué no
GitHub aporta un ejemplo interno de Copilot code review. En un experimento con varias ejecuciones de modelos combinadas, ReviewBench anticipó una subida de precisión, cobertura y volumen de comentarios, junto a un coste menor. Después, la prueba A/B en producción se movió en la misma dirección: la tasa de comentarios atendidos subió un 8 %, la cobertura un 13,6 %, el volumen un 61 % y el coste por revisión bajó un 8 %, siempre respecto al control.
Eso respalda el benchmark como señal previa, no como prueba universal. Los porcentajes son relativos, el anuncio no detalla ahí el tamaño de la muestra y la “tasa atendida” se estima con otro modelo. Además, GitHub desarrolla Copilot y el propio benchmark. Abrir datos y rúbricas ayuda, pero no sustituye una validación independiente.
Tres límites que conviene mirar antes de la clasificación
- La muestra es pequeña frente al universo analizado. Doscientas diecinueve pull requests permiten una evaluación manejable, pero no cubren todos los lenguajes, arquitecturas ni normas internas.
- El código es público. Un revisor puede rendir de otra manera en repositorios privados, monolitos antiguos o proyectos con convenciones propias. Al publicarse el conjunto, también aumenta el riesgo de optimizar expresamente para el examen.
- La evaluación incluye otro modelo de IA. El acuerdo humano del 96,6 % reduce la incertidumbre, pero cualquier leaderboard debe leerse junto a la rúbrica, la versión del juez y los cortes por gravedad.
También hay que distinguir este banco de pruebas del producto. La documentación de Copilot code review explica cómo pedir revisiones, corregir sugerencias o automatizarlas; ReviewBench evalúa sistemas con un procedimiento común. No es una nueva garantía de que cada comentario de Copilot sea correcto.
Cómo usar ReviewBench sin convertirlo en otra cifra de marketing
Para elegir un revisor, primero hay que decidir qué error sale más caro. Si el sistema va a bloquear fusiones, prioriza precisión y hallazgos críticos. Si actúa como una segunda mirada no obligatoria, puede interesar una cobertura mayor. Después conviene ejecutar una prueba con cambios propios, medir falsos positivos por categoría y comprobar cuánto tiempo ahorra o consume la revisión humana.
ReviewBench permite probar un agente con 25 pull requests antes de una ejecución completa de 219 casos y tres rondas. Sirve para comparar versiones, pero un equipo debería añadir código propio y casos de regresión. La noticia sobre DevFest 2026 y sus comunidades de desarrolladores reúne criterios para encontrar sesiones prácticas y contrastar experiencias.
La conclusión: un benchmark útil, no un permiso para dejar de revisar
ReviewBench obliga a separar problemas encontrados, ruido, gravedad y coste. Su aportación no es proclamar un campeón, sino mostrar el intercambio entre precisión y cobertura con datos inspeccionables. La cautela sigue siendo necesaria: corpus limitado, juez basado en IA y validación de producción del mismo ecosistema.
Bien usado, puede reducir decisiones basadas en una demo vistosa. Mal usado, se convertirá en otra cifra sin contexto. La pregunta final no debería ser “¿quién gana el leaderboard?”, sino “¿qué tipo de fallo queremos detectar, cuánto ruido toleramos y qué ocurre cuando el revisor se equivoca en nuestro código?”.